Introduction
Dans deux de nos précédents articles, nous avons vu comment l’architecture Médaillon structurait techniquement la donnée en couches Bronze, Silver et Gold, puis comment la Data Democracy, le Data Product et le Data Mesh permettaient d’organiser les équipes autour de cette donnée. Une question est pourtant restée en arrière-plan, alors qu’elle conditionne tout le reste : où stockons nous concrètement la donnée analytique, et sous quelle forme ?
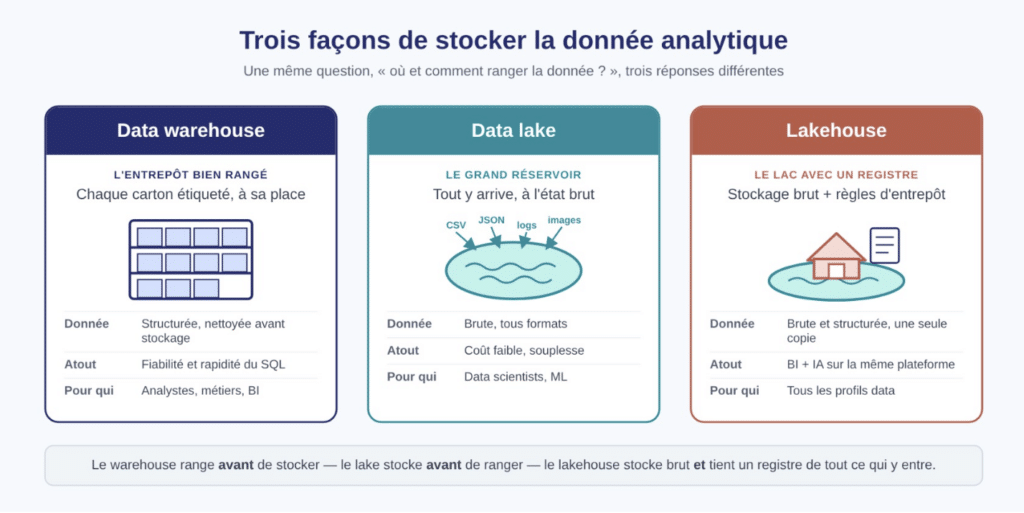
Trois réponses dominent le marché : le data warehouse (entrepôt de données), le data lake (lac de données) et le lakehouse, contraction des deux. Nous les présentons souvent comme des générations successives, la dernière rendant les autres obsolètes mais la réalité est plus nuancée. Voyons d’où viennent ces trois modèles, ce qui les distingue vraiment, et comment choisir.
1. Why do we need storage dedicated to analytics?
Toute entreprise dispose déjà de bases de données : celles de son ERP, de son CRM ou de son site e-commerce. Ces bases sont dites transactionnelles (ou OLTP, Online Transaction Processing) : elles sont optimisées pour enregistrer très vite des milliers de petites opérations, comme une commande, un paiement ou la mise à jour d’une fiche client.
Le problème apparaît dès que les métiers veulent analyser cette donnée : « quel est notre chiffre d’affaires par région sur trois ans ? ». Ces questions parcourent des millions de lignes, et lancées sur les bases de production, elles ralentissent les applications elles-mêmes. Et comme chaque analyste retravaille la donnée brute dans son coin, les chiffres finissent par diverger d’un service à l’autre.
D’où l’idée de copier la donnée dans un espace analytique (OLAP, Online Analytical Processing), séparé des applications et pensé pour la lecture massive. Nos trois modèles sont trois façons de concevoir cet espace, chacune née des limites de la précédente.
2. The Data Warehouse: A Well-Organized Repository
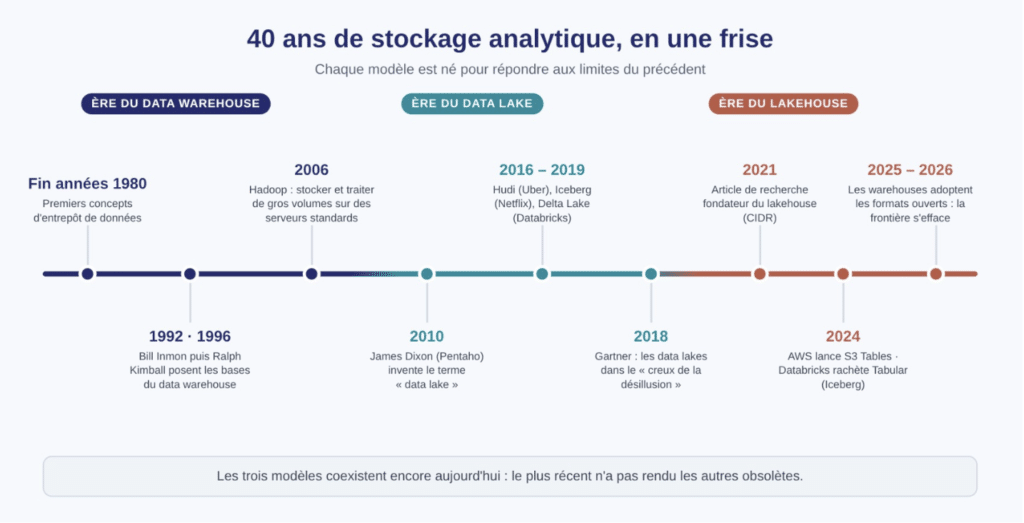
Le data warehouse est le modèle historique formalisé par Bill Inmon, souvent présenté comme son « père », qui le définit comme une collection de données orientée sujet, intégrée, historisée et non volatile au service de la prise de décision. Ralph Kimball popularise ensuite la modélisation dimensionnelle, avec le fameux schéma en étoile : une table de faits (par exemple les ventes) entourée de tables de dimensions (client, produit, date,…).
Son principe fondamental est le schema-on-write (schéma à l’écriture) : la structure des tables est définie avant de charger la donnée. Celle-ci passe donc par un processus ETL (Extract, Transform, Load : extraire, transformer, charger) qui la nettoie avant de la stocker.
The result: clean data that can be immediately used in SQL by BI tools such as Power BI. Today, data warehouses have largely migrated to the cloud: Snowflake, Google BigQuery, andAmazon Redshift.
Strengths
- BI Performance → Fast SQL queries, even with many concurrent users;
- Reliability → ACID transactions (the guarantee that a write operation is either fully committed or not at all), enforced schema, a single version of the counters
- Accessibility → Most analysts are proficient in SQL, and the data arrives “ready to use.”
Limitations
- Structured data only → images, PDFs, or IoT feeds do not integrate well with it;
- Rigidity → Every new source or requirement requires changes to the model and pipelines
- Not well suited for data science → the data has been transformed and aggregated for reporting purposes, whereas a data scientist often needs the raw details;
- Dependence on the editor → the data is stored in a proprietary format that can only be read by the editor's engine.
Une idée reçue sur le coût : Il est souvent énoncé que le stockage d’un data warehouse est « cher ». C’était vrai « on premise ». Dans le cloud, Snowflake facture le stockage autour de 23 $ par To et par mois, l’ordre de grandeur du stockage objet standard. L’essentiel de la facture se joue sur le calcul (typiquement autour de 80 % des dépenses) et sur la dépendance à un format fermé.
3. The data lake: the large repository
In the 2010s, the explosion in data volumes (social media) and the diversity of formats posed challenges for the data warehouse. James Dixon, then CTO of Pentaho, offered a now-famous analogy: “If a data mart is likebottled water—purified and packaged for consumption—adata lakeis a naturallake, fed by many sources, where anyone can come to draw water, observe, or dive in.”
In practical terms, a data lake is a storage space (nowadays almost always cloud object storage such as Amazon S3, Azure Data Lake Storage, or Google Cloud Storage) where data is storedin its original format: table exports, CSV or JSON files, logs, images, and videos. It operates ona “schema-on-read” model: the schema is applied only when we query the data. This shifts us from an ETL (Extract, Transform, Load) approach to anELT(Extract, Load, Transform) approach: we load the data first, then transform it as needed.
Strengths
- Very low storage cost → and virtually unlimited capacity;
- All types of data → structured, semi-structured (JSON, XML), and unstructured (images, text, audio)
- Ideal for data science and machine learning → the raw, complete data is preserved, with no loss of information
- Open formats→ Parquet, ORC, and Avro can be read by many tools.
Limitations
- No transaction guarantees → two transactions that write at the same time can corrupt a dataset
- Poor BI performance → queries are slow when processing large volumes of unoptimized files
- The risk of a “data swamp” → without a catalog or governance, no one knows what’s in the lake or which data is reliable.
This last point is by no means theoretical. In 2018, Gartner placed data lakes in the “trough of disillusionment” on itsHype Cycle, with its analysts explaining that projects fail when the lake is built without governance, metadata, or transactions.
As a result, most companies have ended up using both: a data lake for storage and exploration, and a data warehouse fed by the lake for reporting. This “two-tier” architecture works, but itduplicates data, increases the number of pipelines, and creates discrepancies between what data scientists and analysts see.
4. The lakehouse: the best of both worlds?
It is precisely this dual system that thelakehouse seeks to eliminate. The concept was formalized by the founders of Databricks (Michael Armbrust, Ali Ghodsi, Reynold Xin, and Matei Zaharia) in a research paper presented at the CIDR conference in 2021. Their thesis: we can achieve the guarantees and performance of a data warehouse directly on the open, low-cost storage of a data lake, using a single copy of the data.
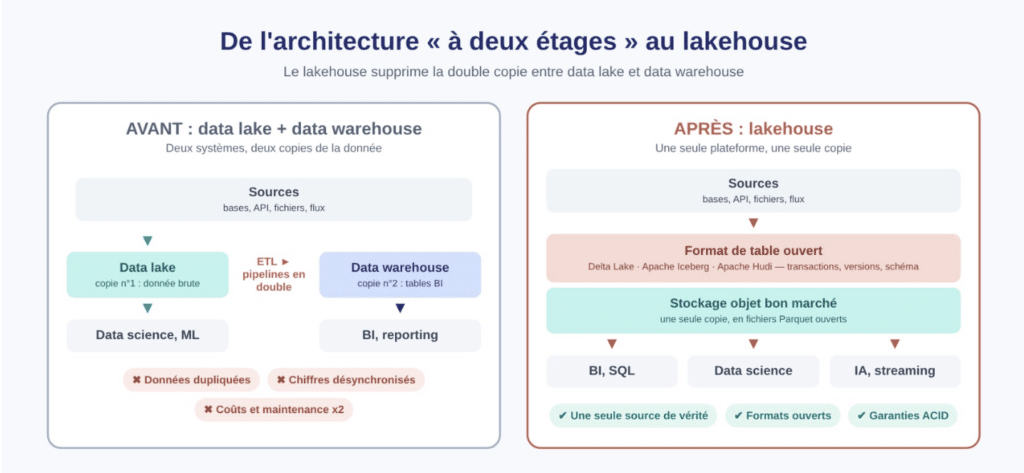
It all hinges on one key component: theopen tableformat. The data remains as Parquet files in object storage, but ametadata layer accompanies them and keeps track of each table: which files make it up, which version is valid, and which schema applies. To borrow Dixon’s analogy, it’s like a lake to which we’ve added a land registry and a log of entries and exits.
Three formats share this role:
- Delta Lake → created by Databricks, open source since 2019, and hosted by the Linux Foundation
- Apache Iceberg → originated at Netflix in 2017; today, it is supported by virtually all data engines (Snowflake, BigQuery, Databricks, AWS services, etc.);
- Apache Hudi → originated at Uber in 2016, with a strong focus on incremental ingestion and streaming.
Ces formats apportent au data lake ce qui lui manquait : transactions ACID, mises à jour et suppressions ligne à ligne, contrôle du schéma, et time travel (la possibilité d’interroger une table telle qu’elle était à une date passée, très utile pour l’audit notamment).
The lakehouse is also the natural environment forthe Medallion architecture discussed in a previous article: the Bronze layer plays the historical role of the lake, the Gold layer that of the warehouse, and the Silver layer serves as the link between them. In practice, these layers are often built using dbt (Data Build Tool), the flagship tool of the Modern Data Stack. Every transformation is a simple SQL query, automatically versioned and tested (for uniqueness, missing values, etc.). Along the way, dbt generates documentation and lineage—that is, a map showing what feeds into what. Each profile works on the same platform, at the level of maturity that suits them.
Unified Governance
Un format de table ne suffit pas à éviter le data swamp : encore faut-il savoir ce que contient le lac, qui en est responsable et qui a le droit d’y accéder. C’est le rôle du catalogue unifié (Unity Catalog, Snowflake Horizon, Apache Polaris…), qui centralise en un seul endroit la documentation, le lineage, les propriétaires et les droits d’accès. Deux modèles de contrôle coexistent :
- RBAC(Role-Based Access Control) → permissions depend on the role: a financial analyst can view the "Gold" tables in the finance department, and nothing else
- ABAC(Attribute-Based Access Control) → Access rights depend on attributes, often labels applied to the data: any column marked as “personal data” is automatically hidden, regardless of the table in which it appears.
L’ABAC passe mieux à l’échelle : nous ne gérons plus des centaines de permissions table par table, mais quelques règles appliquées partout. C’est la traduction concrète de la gouvernance fédérée évoquée dans notre article sur le Data Mesh.
Mais tout n’est pas parfait
- Complexity → A lakehouse combines several components (storage, table format, catalog, computing engines, orchestration) that must be configured and maintained;
- Compétences → Spark, Python, optimisation des fichiers (compaction, partitionnement) : le niveau d’exigence est plus élevé que pour un warehouse purement SQL ;
- Computing costs → storage is inexpensive, but poorly sized clusters billed on a pay-as-you-go basis can quickly drive up the bill;
5. Comparison: The Three Models Side by Side
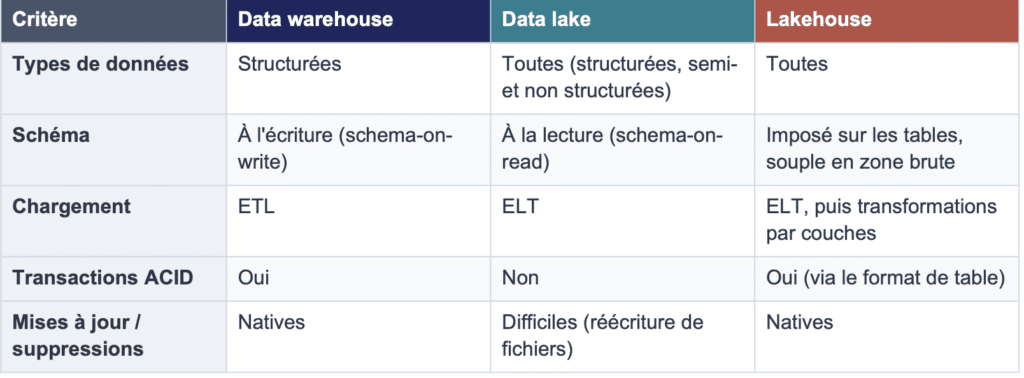
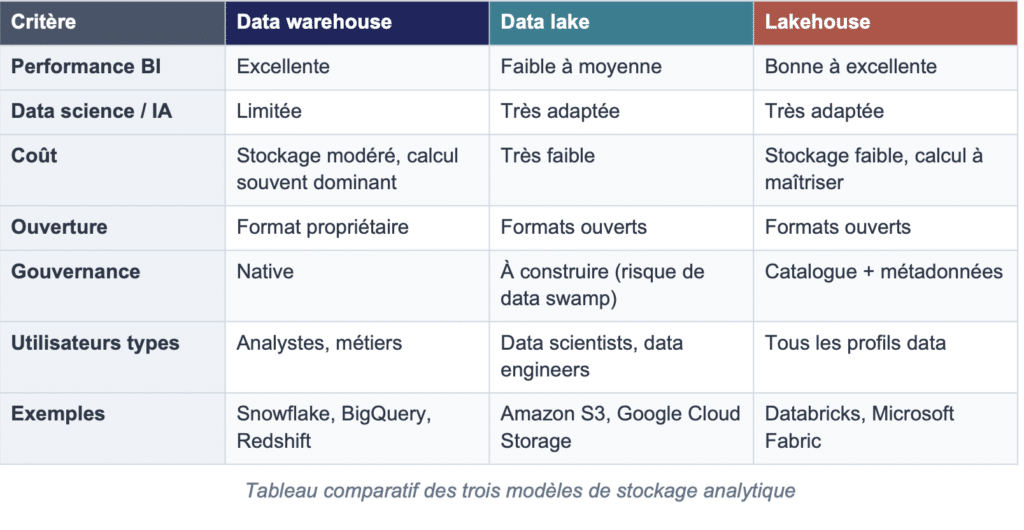
To make things clearer, here is a summary of the main differences in a single table.
6. Which one should you choose for which purpose?
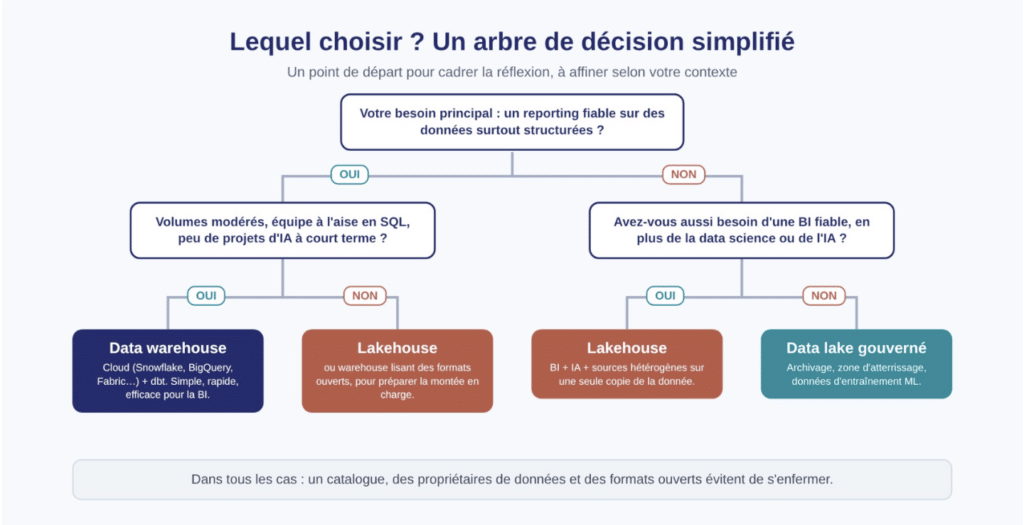
Il n’existe pas de réponse universelle, mais cinq questions permettent de trancher rapidement : quel type de données, quel est la finalité, quel est le volume, quelles sont les contraintes et quelles sont les compétences des utilisateurs finaux ?
The Hybrid
Very common: a lakehouse as the foundation, and a warehouse-style engine for the most heavily used dashboards. Microsoft Fabric exemplifies this convergence: its Lakehouse and Warehouse share the same storage (OneLake) and the same format (Delta Parquet).
2026: The Border Fades Away
Le débat « warehouse contre lakehouse » perd d’ailleurs de sa pertinence. Snowflake gère des tables Iceberg et revendique depuis fin 2025 un positionnement d’« entreprise lakehouse ». AWS a lancé fin 2024 les S3 Tables, un stockage optimisé pour Iceberg, et Databricks a racheté la même année Tabular, la société des créateurs d’Iceberg, pour près de 2 milliards de dollars selon la presse. La vraie question devient : « ma donnée est-elle dans un format ouvert, et quels moteurs peuvent la lire ? »
Conclusion
Data warehouse, data lake et lakehouse ne sont pas trois modes successives dont la dernière effacerait les précédentes. Le data warehouse apporte la fiabilité et la performance du reporting, le data lake la souplesse et le faible coût pour la donnée brute et l’IA, et le lakehouse réunit les deux sur une seule copie de la donnée grâce aux formats de table ouverts.
The right choice depends less on the latest technology and more on your data sources, your users, your data volumes, and your teams’ skills. A BI-focused company will often be better served by a cloud data warehouse; an organization that combines BI, AI, and heterogeneous data sources will find the lakehouse to be a more sustainable foundation. In any case, the same rule applies: an architecture is only valuable if it is governed, documented, and actually used.
Are you looking for experts who can guide you in implementing a data strategy that integrates architecture, governance, and analytical insights?
Learn more about our Product Data/AI Practice: https://www.5degres.com/product-data/
FAQ
What is the main difference between a data warehouse and a data lake?
Le data warehouse stocke une donnée structurée, déjà nettoyée et modélisée avant son chargement (schema-on-write), pour un usage BI et reporting. Le data lake stocke la donnée brute, dans tous les formats, et ne lui applique une structure qu’au moment de l’analyse (schema-on-read). Le premier privilégie la fiabilité et la performance, le second la souplesse et le faible coût.
Qu’est-ce qu’un lakehouse, en une phrase ?
Un lakehouse est un data lake auquel on a ajouté une couche de métadonnées (un format de table ouvert comme Delta Lake, Iceberg ou Hudi) qui lui apporte les garanties d’un data warehouse : transactions ACID, mises à jour, contrôle du schéma et performances SQL, sur une seule copie de la donnée.
Does the lakehouse replace the data warehouse?
Not always. It is a beneficial alternative to the “lake + warehouse” architecture in organizations that combine BI, AI, and various data sources. For a reporting-focused structure with primarily structured data, a cloud data warehouse is often simpler and less expensive to operate. And the two are converging: data warehouses can now read and write open formats.
Qu’est-ce qu’un « data swamp » et comment l’éviter ?
C’est un data lake devenu inexploitable : personne ne sait plus ce qu’il contient, d’où viennent les données, ni lesquelles sont fiables. Pour l’éviter : un catalogue de données documentant chaque jeu de données, des propriétaires identifiés, des règles de qualité, une organisation en couches (type Médaillon) et un format de table transactionnel.
What are Delta Lake, Apache Iceberg, and Apache Hudi?
Ce sont des formats de table ouverts. Ils ajoutent au-dessus de fichiers Parquet un journal de métadonnées qui permet les transactions, les mises à jour, les suppressions et le time travel. Delta Lake vient de Databricks, Iceberg de Netflix et Hudi d’Uber. Iceberg est aujourd’hui le plus largement supporté par les différents moteurs du marché.
Quel lien avec l’architecture Médaillon ?
Le lakehouse est l’environnement naturel de l’architecture Médaillon. La couche Bronze joue le rôle du data lake (donnée brute), la couche Gold celui du data warehouse (tables modélisées pour la BI), et la couche Silver fait le pont entre les deux.
Main sources used:
- Lakehouse: A New Generation of Open Platforms That Unify Data Warehousing and Advanced Analytics — Armbrust, Ghodsi, Xin, Zaharia (CIDR 2021)
- Data Warehouse vs. Data Lake vs. Data Lakehouse — Atlan
- Data Lakehouse vs. Data Warehouse vs. Data Lake — Apache Hudi (2026)
- Gartner D&A Summit 2023: Gartner's Vision for the Data Lake and Lakehouse — Solutions
- A Growing Gap Between Data Lake Expectations and Reality — Tamr (Gartner Hype Cycle)
- Apache Iceberg vs. Delta Lake vs. Apache Hudi (2026) — RisingWave
- Databricks reportedly paid $2 billion for the Tabular acquisition — TechCrunch
- Amazon S3 Tables (managed Apache Iceberg tables) — Business Wire / AWS
- Snowflake Delivers the Enterprise Lakehouse — Snowflake (Nov. 2025)
- Storing Data in Microsoft Fabric (OneLake, Lakehouse vs. Data Warehouse) — Microsoft Learn