Introduction
Dans deux de nos précédents articles, nous avons vu comment l’architecture Médaillon structurait techniquement la donnée en couches Bronze, Silver et Gold, puis comment la Data Democracy, le Data Product et le Data Mesh permettaient d’organiser les équipes autour de cette donnée. Une question est pourtant restée en arrière-plan, alors qu’elle conditionne tout le reste : où stockons nous concrètement la donnée analytique, et sous quelle forme ?
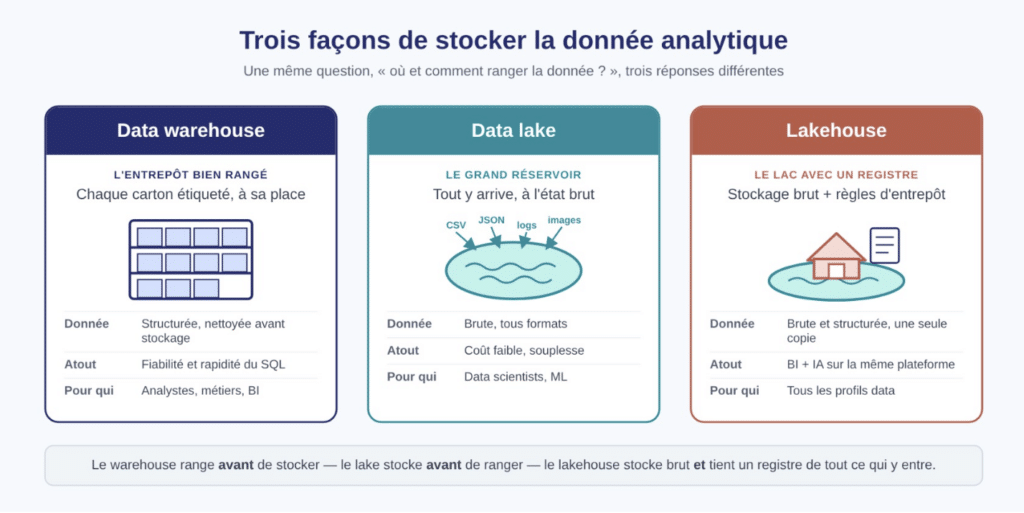
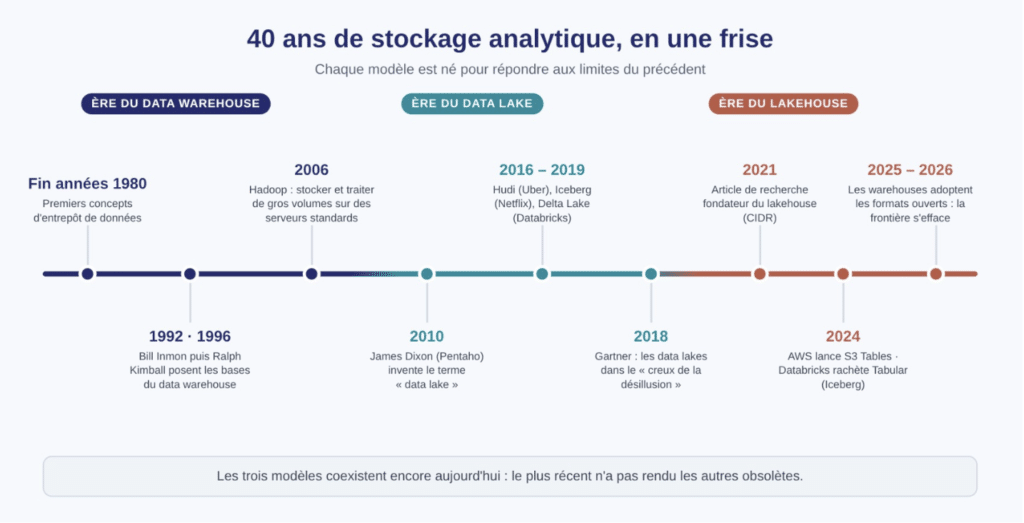
Trois réponses dominent le marché : le data warehouse (entrepôt de données), le data lake (lac de données) et le lakehouse, contraction des deux. Nous les présentons souvent comme des générations successives, la dernière rendant les autres obsolètes mais la réalité est plus nuancée. Voyons d’où viennent ces trois modèles, ce qui les distingue vraiment, et comment choisir.
1. Pourquoi a-t-on besoin d’un stockage dédié à l’analyse ?
Toute entreprise dispose déjà de bases de données : celles de son ERP, de son CRM ou de son site e-commerce. Ces bases sont dites transactionnelles (ou OLTP, Online Transaction Processing) : elles sont optimisées pour enregistrer très vite des milliers de petites opérations, comme une commande, un paiement ou la mise à jour d’une fiche client.
Le problème apparaît dès que les métiers veulent analyser cette donnée : « quel est notre chiffre d’affaires par région sur trois ans ? ». Ces questions parcourent des millions de lignes, et lancées sur les bases de production, elles ralentissent les applications elles-mêmes. Et comme chaque analyste retravaille la donnée brute dans son coin, les chiffres finissent par diverger d’un service à l’autre.
D’où l’idée de copier la donnée dans un espace analytique (OLAP, Online Analytical Processing), séparé des applications et pensé pour la lecture massive. Nos trois modèles sont trois façons de concevoir cet espace, chacune née des limites de la précédente.
2. Le data warehouse : l’entrepôt bien rangé
Le data warehouse est le modèle historique formalisé par Bill Inmon, souvent présenté comme son « père », qui le définit comme une collection de données orientée sujet, intégrée, historisée et non volatile au service de la prise de décision. Ralph Kimball popularise ensuite la modélisation dimensionnelle, avec le fameux schéma en étoile : une table de faits (par exemple les ventes) entourée de tables de dimensions (client, produit, date,…).
Son principe fondamental est le schema-on-write (schéma à l’écriture) : la structure des tables est définie avant de charger la donnée. Celle-ci passe donc par un processus ETL (Extract, Transform, Load : extraire, transformer, charger) qui la nettoie avant de la stocker.
Résultat : une donnée propre et immédiatement exploitable en SQL par les outils de BI comme Power BI. Aujourd’hui, les data warehouses ont largement migré dans le cloud : Snowflake, Google BigQuery, ou encore Amazon Redshift.
Points forts
- Performance BI → requêtes SQL rapides, même avec de nombreux utilisateurs simultanés ;
- Fiabilité → transactions ACID (la garantie qu’une écriture est soit entièrement appliquée, soit pas du tout), schéma imposé, une seule version des indicateurs
- Accessibilité → le SQL est maîtrisé par la plupart des analystes, et la donnée arrive « prête à être consommée ».
Limites
- Données structurées uniquement → images, PDF ou flux IoT s’y intègrent mal ;
- Rigidité → chaque nouvelle source ou nouveau besoin impose de faire évoluer le modèle et les pipelines
- Peu adapté à la data science → la donnée a été transformée et agrégée pour le reporting, alors qu’un data scientist a souvent besoin du détail brut ;
- Dépendance à l’éditeur → la donnée est stockée dans un format propriétaire, lisible uniquement par le moteur de l’éditeur.
Une idée reçue sur le coût : Il est souvent énoncé que le stockage d’un data warehouse
est « cher ». C’était vrai « on premise ». Dans le cloud, Snowflake facture le stockage autour de 23 $ par To et par mois, l’ordre de grandeur du stockage objet standard. L’essentiel de la facture se joue sur le calcul (typiquement autour de 80 % des dépenses) et sur la dépendance à un format fermé.
3. Le data lake : le grand réservoir
Dans les années 2010, l’explosion des volumes (réseaux sociaux) et la diversité des formats mettent le data warehouse en difficulté. James Dixon, alors CTO de Pentaho, propose une image restée célèbre : « si le data mart est comparable à de l’eau en bouteille, nettoyée et conditionnée pour être consommée, le data lake est un lac à l’état naturel, alimenté par de nombreuses sources, dans lequel chacun peut venir puiser, observer ou plonger ».
Concrètement, un data lake est un espace de stockage (aujourd’hui presque toujours du stockage objet cloud comme Amazon S3, Azure Data Lake Storage ou Google Cloud Storage) dans lequel la donnée est déposée dans son format d’origine : exports de tables, fichiers CSV ou JSON, logs, images, vidéos. Il fonctionne en schema-on-read (schéma à la lecture) : la structure n’est appliquée qu’au moment où nous interrogeons la donnée. Nous passons ainsi d’une logique ETL à une logique ELT (Extract, Load, Transform) : nous chargeons d’abord, nous transformons ensuite, selon le besoin.
Points forts
- Coût de stockage très faible → et une capacité quasi illimitée ;
- Tous types de données → structurées, semi-structurées (JSON, XML) et non structurées (images, textes, audio)
- Idéal pour la data science et le machine learning → la donnée brute et complète est conservée, sans perte d’information
- Formats ouverts → Parquet, ORC ou Avro sont lisibles par de nombreux outils.
Limites
- Pas de garanties transactionnelles → deux traitements qui écrivent en même temps peuvent corrompre un jeu de données
- Performances BI médiocres → sur de gros volumes de fichiers non optimisés, les requêtes sont lentes
- Le risque du « data swamp » (marécage de données) → sans catalogue ni gouvernance, plus personne ne sait ce que contient le lac ni quelle donnée est fiable.
Ce dernier point n’a rien de théorique. En 2018, Gartner plaçait les data lakes dans le «creux de la désillusion » de son Hype Cycle, ses analystes expliquant que les projets échouent quand le lac est construit sans gouvernance, sans métadonnées et sans transactions.
Résultat : la plupart des entreprises ont fini par faire cohabiter les deux, un data lake pour stocker et explorer, un data warehouse alimenté par le lac pour le reporting. Cette architecture « à deux étages » fonctionne, mais elle duplique la donnée, multiplie les pipelines et crée des décalages entre ce que voient data scientists et analystes.
4. Le lakehouse : le meilleur des deux mondes ?
C’est précisément ce double système que le lakehouse cherche à supprimer. Le concept est formalisé par les fondateurs de Databricks (Michael Armbrust, Ali Ghodsi, Reynold Xin et Matei Zaharia) dans un article de recherche présenté à la conférence CIDR en 2021. Leur thèse : nous pouvons obtenir les garanties et les performances d’un data warehouse directement sur le stockage ouvert et bon marché d’un data lake, avec une seule copie de la donnée.
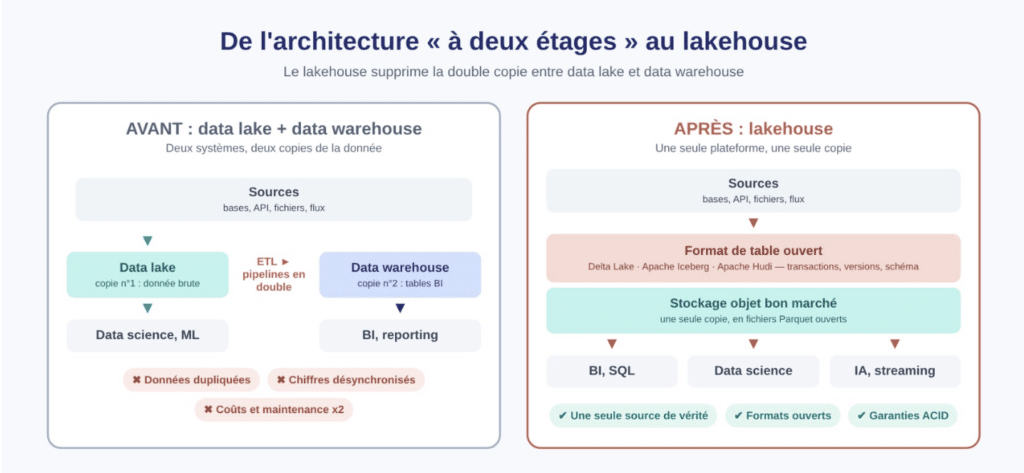
Tout repose sur une brique : le format de table ouvert (open table format). Les données restent des fichiers Parquet dans le stockage objet, mais une couche de métadonnées les accompagne et tient le registre de chaque table : quels fichiers la composent, quelle version est valide, quel schéma s’applique. Pour reprendre l’analogie de Dixon, c’est un lac auquel nous aurions ajouté un cadastre et un registre des entrées et sorties.
Trois formats se partagent ce rôle :
- Delta Lake → créé par Databricks, open source depuis 2019 et hébergé par la Linux Foundation
- Apache Iceberg → né chez Netflix en 2017, aujourd’hui lu par la quasi-totalité des moteurs (Snowflake, BigQuery, Databricks, services AWS,…) ;
- Apache Hudi → né chez Uber en 2016, très orienté ingestion incrémentale et streaming.
Ces formats apportent au data lake ce qui lui manquait : transactions ACID, mises à jour et suppressions ligne à ligne, contrôle du schéma, et time travel (la possibilité d’interroger une table telle qu’elle était à une date passée, très utile pour l’audit notamment).
Le lakehouse est aussi l’environnement naturel de l’architecture Médaillon vue dans un précédent article : la couche Bronze joue le rôle historique du lac, la couche Gold celui du warehouse, et la couche Silver fait le lien. Concrètement, ces couches se construisent souvent avec dbt (data build tool), l’outil emblématique de la Modern Data Stack. Chaque transformation y est une simple requête SQL, versionnée et testée automatiquement (unicité, valeurs manquantes,…). dbt génère au passage la documentation et le lineage, c’est-à-dire la carte de qui alimente quoi. Chaque profil travaille sur la même plateforme, au niveau de maturité qui lui convient.
Une gouvernance unifiée
Un format de table ne suffit pas à éviter le data swamp : encore faut-il savoir ce que contient le lac, qui en est responsable et qui a le droit d’y accéder. C’est le rôle du catalogue unifié (Unity Catalog, Snowflake Horizon, Apache Polaris…), qui centralise en un seul endroit la documentation, le lineage, les propriétaires et les droits d’accès. Deux modèles de contrôle coexistent :
- RBAC (Role-Based Access Control) → les droits dépendent du rôle : un analyste finance lit les tables Gold de la finance, et rien d’autre
- ABAC (Attribute-Based Access Control) → les droits dépendent d’attributs, souvent des étiquettes posées sur les données : toute colonne marquée « donnée personnelle » est automatiquement masquée, quelle que soit la table où elle se trouve.
L’ABAC passe mieux à l’échelle : nous ne gérons plus des centaines de permissions table par table, mais quelques règles appliquées partout. C’est la traduction concrète de la gouvernance fédérée évoquée dans notre article sur le Data Mesh.
Mais tout n’est pas parfait
- Complexité → un lakehouse assemble plusieurs briques (stockage, format de table, catalogue, moteurs de calcul, orchestration) qu’il faut configurer et maintenir ;
- Compétences → Spark, Python, optimisation des fichiers (compaction, partitionnement) : le niveau d’exigence est plus élevé que pour un warehouse purement SQL ;
- Coût du calcul → le stockage est bon marché, mais des clusters mal dimensionnés et facturés à l’usage peuvent vite faire grimper la facture ;
5. Comparatif : les trois modèles côte à côte
-
Pour y voir plus clair, voici les principales différences résumées en un seul tableau.