En octobre 2020, Public Health England venait de perdre 15 841 cas positifs de Covid-19 dans ses chiffres quotidiens, à cause d’un format Excel limité à environ 65 000 lignes. À la Chambre des communes, on a demandé au ministre de la Santé, Matt Hancock, de rendre publics d’autres schémas de flux de données pour débusquer d’éventuelles failles cachées. Il a promis de voir ce qui était possible. Il a aussi prévenu qu’une erreur de taille maximale de fichier « n’apparaîtrait pas forcément sur ce genre de logigrammes » (BBC).
La remarque vaut bien au-delà de l’Angleterre. On peut documenter avec soin une chaîne de données et passer à côté de ce qui la fera casser. Un schéma décrit. La gouvernance désigne quelqu’un pour vérifier, et prévoit ce qui se passe quand la vérification échoue.
Pour que cela tienne, il faut quatre piliers : des rôles, des règles (avec les contrôles et les processus qui les font appliquer), des outils et une culture qui fait vivre l’ensemble. Aucun ne tient seul. Un outil sans responsables donne un catalogue vide, et des responsables sans processus donnent surtout des réunions.
Des rôles avant les outils
Les intitulés changent d’une entreprise à l’autre, mais on retrouve en général ces rôles :
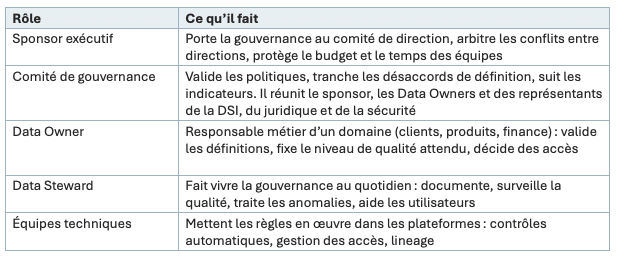
À notre avis, une erreur fréquente consiste à nommer le Data Owner côté technique, parce que « c’est lui qui gère la base ». Or celui qui administre une table n’a pas à décider de ce qu’est un client actif. La responsabilité reste au métier, et la technique garde et fait tourner les données. Gartner ne dit pas autre chose quand il rappelle que la qualité des données est une discipline métier.
Notre article Erreur humaine, erreur de l’IA… et si le vrai bug était entre les deux ? décrit le même piège dans les systèmes multi-agents : « si chaque agent suppose qu’un autre s’en charge, personne ne s’en charge ». Remplacez « agent » par « équipe » et vous tenez l’explication de bien des données orphelines.
Des règles, et de quoi les vérifier
Trois types de textes coexistent, et les mélanger rend les règles illisibles. Une politique dit ce qu’on veut obtenir et pourquoi : « toute donnée personnelle a une durée de conservation définie ». Un standard dit comment faire, de façon vérifiable : dates au format ISO 8601, unités du système international, règles de nommage des tables. Le glossaire métier, lui, fixe le sens des mots, comme « client actif » ou « chiffre d’affaires net ».
Encore faut-il vérifier que les standards sont appliqués. En 1999, la NASA a perdu la sonde Mars Climate Orbiter. La documentation d’interface imposait des unités métriques, mais un fichier produit par un logiciel au sol, « Small Forces », donnait les performances des propulseurs en unités anglo-saxonnes. Les équipes chargées de la trajectoire s’en tenaient aux exigences et les ont prises pour des valeurs métriques. À l’arrivée, la sonde est passée environ 170 km plus bas que prévu, et elle a été perdue.
La commission d’enquête le dit simplement : des erreurs arrivent sur les projets spatiaux, et des processus sont en général en place pour les intercepter avant qu’elles ne deviennent critiques. Celle-ci n’a pas été interceptée, et la commission relève parmi les causes une vérification insuffisante du logiciel au sol. La règle existait, mais le contrôle n’a pas couvert ce maillon.
Pour chaque standard important, posez donc deux questions : quel test automatique le vérifie ? Qui est prévenu quand ce test échoue ?
Des processus pour appliquer les règles
Les politiques disent quoi faire. Les processus disent qui agit, et dans quel délai. Quatre situations méritent une procédure écrite dès le départ :
- une demande d’accès à des données sensibles : qui valide, et en combien de temps ;
- une anomalie de qualité, à corriger à la source plutôt que dans le rapport final, avec une analyse après coup si l’incident est sérieux ;
- l’arrivée d’une nouvelle source, qui reçoit un propriétaire, un niveau de sensibilité et une durée de conservation, plus une ligne au registre si elle contient des données personnelles ;
- un désaccord de définition entre deux domaines, tranché en comité puis inscrit au glossaire avec sa date.
Entre les équipes qui produisent les données et celles qui les utilisent, ces règles peuvent prendre la forme d’un contrat de service. Notre article Data Engineering vs Data Science : comment ces deux disciplines travaillent ensemble ? détaille ce qu’on peut y mettre : taux de valeurs manquantes acceptable, règles de validation, fréquence d’actualisation, et un RACI pour savoir qui corrige quoi.
Pour les violations de données personnelles, la procédure se prépare à froid. La CNIL attend une notification initiale dans les 72 heures suivant la constatation de la violation, si possible. Dans ce délai, personne n’a le temps de chercher qui doit prévenir qui.
Des outils au service des règles
Quatre familles d’outils se partagent le travail. Le catalogue de données recense les jeux de données avec leurs métadonnées, leurs propriétaires et leurs descriptions. Le data lineage suit le parcours d’une donnée de la source au tableau de bord, transformations comprises. Les outils de qualité lancent des tests dans les pipelines et alertent en cas d’écart. La gestion des accès applique les niveaux de sensibilité, du masquage aux droits attribués selon le rôle.
Les outils de traitement comptent aussi. Comme l’explique notre article Notebook ou ETL : le paradigme des pipelines data, les outils ETL offrent un lineage automatique qu’un notebook ne fournit pas sans investissement supplémentaire. Aucun outil ne remplace pour autant l’organisation. Notre article sur l’architecture Médaillon le rappelle : une architecture bien structurée « ne remplace pas une véritable stratégie de gouvernance ni une organisation claire des responsabilités entre équipes ».
Revenons à la remarque de Matt Hancock. Un lineage montre par où passent les données, pas les limites des formats qu’elles traversent. Ajoutez-y des contrôles de volume : combien de lignes entrent dans chaque étape, et combien en sortent.
Une culture qui fait vivre l’ensemble
En septembre 2026, Gartner a publié une prédiction sans détour. D’ici 2027, 60 % des organisations qui ignorent les freins culturels à la gouvernance des données échoueront à gouverner l’IA. Le cabinet s’appuie sur une enquête menée en mars 2026 auprès de 223 responsables data & analytics. La résistance culturelle y passe devant le manque de budget comme première cause d’échec des programmes de gouvernance, à 60 % contre 40 %.
Par culture, Gartner entend les mentalités, les comportements et les normes qui décident si la gouvernance est adoptée, puis si elle dure. Son analyste Anurag Raj observe que beaucoup d’organisations restent concentrées sur la rédaction de politiques et sur la technologie, et négligent cette dimension. Pour lui, une gouvernance des données qui ne s’occupe pas de culture data est un effort vain. Le cabinet recommande d’en faire un « sport d’équipe », avec une responsabilité partagée entre métiers et techniques plutôt qu’une affaire de DSI, et de l’intégrer aux façons de travailler existantes.
En pratique, et sans étude pour le prouver, le bon réflexe doit être le plus simple à suivre. La définition d’un indicateur a sa place dans le catalogue de données, qui sert de référence quel que soit l’outil de BI. La rattacher à un seul outil de visualisation, c’est s’enfermer chez un éditeur. Encore faut-il que ce catalogue soit consulté : une référence que personne n’ouvre ne change aucune habitude. Le temps que les stewards consacrent à leur rôle doit aussi compter dans leurs objectifs annuels, sinon il passera après tout le reste.
Et quand c’est un agent d’IA qui écrit ?
Ces quatre piliers tiennent en peu de pages : un tableau de rôles, quelques règles assorties de tests, un catalogue, du temps reconnu pour les stewards. Le plus difficile est ailleurs. Il faut que quelqu’un s’en serve le lundi matin, et que chaque règle ait quelqu’un pour la vérifier.
Une question va vite devenir pratique : quand un agent d’IA écrit dans une base de référence, qui en est le Data Owner ? L’équipe qui l’a déployé, ou le métier propriétaire de la donnée ? Nous n’avons pas de réponse universelle. Nous pensons seulement qu’elle doit être écrite avant le premier incident, pas après.
La partie 3 de cette série passe à la pratique, du premier diagnostic aux indicateurs de suivi.
FAQ
Quelle différence entre un Data Owner et un Data Steward ?
Le Data Owner est le responsable métier d’un domaine : il valide les définitions, fixe le niveau de qualité attendu et décide des accès. Le Data Steward travaille au quotidien sur ce domaine : il documente, surveille la qualité et traite les anomalies. Le premier décide, le second fait vivre la décision.
Faut-il un outil de data catalog pour démarrer ?
Il faut un catalogue, pas forcément un outil dédié dès le premier jour (c’est un avis). Pour un pilote, le glossaire et la liste des propriétaires peuvent tenir dans un espace simple, à condition qu’il soit indépendant de vos outils de BI et que les équipes le consultent. Un outil devient utile quand les jeux de données sont trop nombreux pour une mise à jour à la main, ou quand il faut un lineage automatique. Choisissez-le après avoir nommé les responsables : sans propriétaires, un catalogue devient vite une liste de tables dont personne ne s’occupe.
Questions subsidiaires
- Qui, dans votre organisation, a aujourd’hui le pouvoir de dire « ce chiffre est le bon », et le sait-il ?
- Parmi vos standards de données, lesquels ne sont vérifiés par aucun test automatique ?
- Vos définitions d’indicateurs survivraient-elles à un changement d’outil de BI ?
- Combien d’heures par mois vos stewards consacrent-ils réellement à ce rôle, et quelqu’un le mesure-t-il ?
Sources
- BBC News, « Excel: Why using Microsoft’s tool caused Covid-19 results to be lost », 5 octobre 2020.
- NASA, Lessons Learned Information System, leçon n° 641 (Mars Climate Orbiter).
- Gartner, communiqué du 21 septembre 2026 sur la culture et la gouvernance de l’IA.